摘要:临床试验里,脱落、缺失、删失是三个不同的概念。一组15例的模拟数据说明:同一批患者,换了缺失数据的处理方式,中位总生存期就从110天变成118天或82天。
在临床试验里,脱落、缺失、删失经常被混着用,但它们不是一回事:脱落是运营事件,缺失是数据状态,删失是统计处理。
用一组15例患者的模拟数据做个演示——同样一批患者,只改变对缺失数据的处理方式,中位总生存期(OS)就分别是 110天、118天、82天。药没有变,患者没有变,变的是统计师对不完整数据的处理方式。
这三个词——脱落(Dropout)、缺失(Missing)、删失(Censoring)——在项目沟通中经常被混着用。但它们是三件事,发生在三个层面,代价也各不相同。
全文分上下两篇。上篇把这三个词讲清楚,看清删失在 OS 分析中的代价;下篇进入 PFS 与安全性评价,看缺失数据如何一级一级传导下去。
01 脱落、缺失、删失:三个词,三层含义
脱落,是运营层面发生的事实:参与者提前终止了试验参与。常见原因包括撤回知情同意、失访、安全性问题等(不包括因研究终止导致的退出)。它直接导致主要研究指标无法获取。
缺失,是数据管理层面的状态:某个访视、某个指标的值没有被记录或无法获取。缺了一次肿瘤评估、参与者记不清既往用药的开始时间,都属于缺失。
删失,是统计分析层面的处理手段:肿瘤项目中的时间-事件指标(OS、PFS等)在未观测到事件时,统计上作删失处理。在生存分析里,这类删失属于右删失(right censoring),也是肿瘤项目中最常见的一类。脱落是导致删失的原因之一,但不是唯一原因——数据截止时仍存活的患者,同样要被删失。
一句话区分:脱落是"人走了"(运营事件),缺失是"值没了"(数据状态),删失是"事件未观测到,但仍有信息可用"(统计概念)。所以,删失 ≠ 脱落。
再把视角往下推一层。统计上按缺失机制把这三种情形分成三类——完全随机缺失(MCAR)、随机缺失(MAR)、非随机缺失(MNAR)。脱落通常落在 MAR 或 MNAR 里:前者缺失与已观测到的变量有关,控制这些变量后不影响结论;后者缺失直接与未观测到的结局有关,比如病情恶化的患者更容易退出——这也是为什么必须逐例记录脱落原因。
02 OS 与 PFS:右删失到底删在哪一天
OS(总生存期):从随机化至任何原因死亡的时间,删失发生在末次已知存活日期——失访患者在这里被删失。
PFS(无进展生存期):从随机化至首次记录疾病进展或死亡的时间,删失发生在末次肿评日期。
Kaplan-Meier 法和 Cox 模型的无偏性,建立在一个前提上:非信息性删失(non-informative censoring)——删失机制独立于患者预后。据此,删失可以分成两类:
非信息性删失:研究结束或达到计划分析截点。它不影响估计的无偏性,但过早结束分析会降低统计检验效能。
信息性删失:脱落且事件是否发生未知、或疾病进展(PD)前连续缺失肿评(无法判断PD是否发生在缺失期间)。它会引入估计偏倚——KM曲线被高估或低估,HR估计值偏离真实情况。
03 脱落率 10% 意味着什么:为什么必须做敏感性分析
样本量估算时假设脱落率10%,是很多项目的常规设定。但脱落真正进入分析时,影响要分两种情形看。
如果脱落与预后无关,它不带来偏倚,但会直接减少事件数,使得把握度随之下降——要么多入组受试者,要么延长随访期,都是成本。
如果疾病恶化的患者更容易脱落(比如因并发症退出),删失就集中在预后差的患者中,KM曲线会系统性高估生存率,中位OS和HR估计都被扭曲。此时脱落不再只是"删失处理完即可"的操作问题,而是统计推断有效性的威胁。
监管对此的应对方式,写进了 ICH E9(R1) 的估计目标(estimand)框架里——主分析之外,必须做敏感性分析(以OS为例):
主分析:删失至患者最后一次被确认存活的时间点(或+1天);
敏感性分析:"最坏情况"假设——假设所有失访患者在失访后立即死亡,或在失访后6个月内全部死亡,重新计算OS。如果结论依然成立,说明结果稳健。
需要区分的是,ICH E9(R1) 把分析分成三层:主分析回答主要问题;敏感性分析针对同一个估计目标,检验结论对缺失数据假设的稳健性;补充分析回答另一个角度的临床问题。这里的"最坏情况"假设属于第一类——它检验的是:如果失访患者的结局比我们假设的差得多,结论还站得住吗。
04 一组数字:同一批患者,三个中位生存期
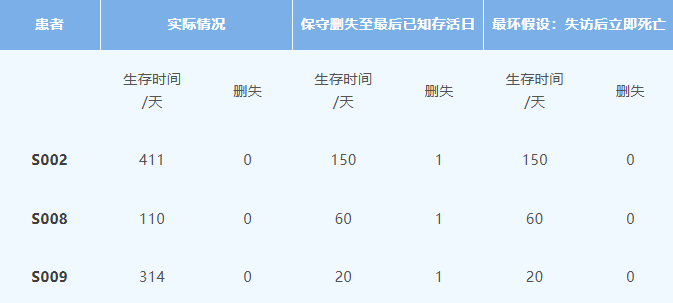
节选示例中受脱落影响的 3 例患者,其余 12 例三种处理下结果相同。
用一组15例患者的模拟示例,看删失处理方式到底能改变什么。三种处理分别是:实际情况(上帝视角)、保守删失(删失至最后已知存活日)、最坏假设(失访后立即死亡)。备注:0=事件,1=删失。
三种处理下,中位生存期分别为:实际情况110天,保守删失118天,最坏假设82天。保守删失把中位生存期"拉长"了8天,最坏假设把它"压短"了28天。在KM曲线上,三条线越到随访后期分得越开。
删失方式不是统计师的技术偏好,而是能改变结论方向的选择。
05 死亡日期缺失怎么办:区间填补、边界填补与最坏情况假设
OS分析里还有更细的麻烦:知道患者去世了,但日期不完整。有两类场景:
A. 完全无法获知死亡日期——患者确已死亡,EDC显示完全缺失。正确的动作是继续溯源,而不是马上填补;实在无法确定到日,也要尽可能框定死亡区间。
B. 已知死亡但日期不详——仅有月份或年份信息,无法精确到日。
常用的填补策略包括:区间填补(interval imputation),方法上最严谨,但不是所有审评员都熟悉;区间中点或均匀分布点估计,取末次接触与死亡确认日的中点;边界填补,死亡时间取最后已知存活日期(生存时间最短,最保守,对试验药最"苛刻"),或取随访日期(生存时间最长,容易偏乐观)。
这是"日期不完整"的处理。更常见的一类缺失是整段访视数据缺失,处理路线通常是多重插补(MI)或重复测量的混合效应模型(MMRM);预设敏感性分析时,tipping point 分析(找到使结论翻转的临界假设)比单一填补更能说明问题。
仍然用那组15例患者的示例,比较实际结果与两种填补:
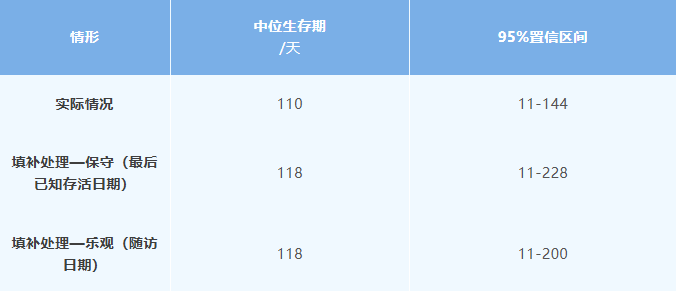
中位生存期之外,还有一个容易被忽略的细节:两种填补的点估计接近,置信区间上限却从144分别移动到了228和200。不同填补方法可使中位OS估计偏移一个随访周期,并在高失访比例下放大HR置信区间宽度。
花两周继续溯源,比在SAP里发明五种填补规则更能让监管放心。EDC中死亡时间字段的设置,应允许部分缺失,而不是强制录入完整日期。填补规则必须在统计分析计划(SAP)中预设,并在CSR中报告方法学限制。
常见问题
Q:删失和脱落有什么区别?
脱落是运营层面的事实——参与者提前终止了试验参与;删失是统计分析层面的处理手段——事件未观测到时在统计上做删失处理。脱落是导致删失的原因之一,但不等于删失:数据截止时仍存活的患者同样会被删失。
Q:什么是右删失?
右删失(right censoring)指随访结束时仍未观测到目标事件,只知道受试者在某个时间点之前没有发生事件。临床试验中最常见的就是右删失。
Q:信息性删失和非信息性删失怎么区分?
看删失机制是否独立于患者预后。非信息性删失(研究结束、达到分析截点)不影响估计的无偏性;信息性删失(疾病恶化导致退出)会引入偏倚,使 KM 曲线被系统性高估或低估。
Q:临床试验的脱落率一般设定多少?
样本量估算时通常按 10%–20% 设定脱落率。脱落率假设越高,所需样本量越大——脱落是成本,也是统计推断有效性的变量。
Q:死亡日期只知道月份,怎么填补?
常见策略有三种:区间填补(方法上最严谨)、区间中点或均匀分布点估计、边界填补(取最后已知存活日期最保守,取随访日期偏乐观)。不同方法可使中位 OS 估计偏移约一个随访周期,并放大 HR 置信区间宽度。
Q:什么是 ICH E9(R1)?
ICH E9(R1) 是国际人用药品注册技术协调会关于临床试验估计目标(estimand)与敏感性分析的附录,要求把试验目的翻译成精确的估计目标,并预先界定主分析、敏感性分析与补充分析。
上篇小结:删失处理方式能改变结论方向
到这里,讨论都还在OS这条线上:删失定在哪一天、死亡日期怎么补,代价是可以用数字称出来的。
OS事件的评估相对客观公正,删失对结论的影响尚且比较大,而PFS的核心数据来自按周期进行的影像评估——一次被错过的检查,影响的就不只是某一个时间点。
下篇预告:PFS 连续缺失肿评的三重风险
PFS:连续缺失肿评的三重风险;安全性评价:AE日期缺失、既往/合并用药日期缺失,如何连锁影响判定;三道防线:一条多方共守的数据质量责任链。