研究者评估
与 BICR 差多少算正常?
一项覆盖 2 万例病例的研究
给出了第一个经验基准
2026年9月,一项基于 39 项注册性试验、超过 2 万例受试者数据的研究,第一次把研究者评估与独立影像评估的差异率量化到个例层面。对申办方来说,这意味着差异从"说不清的常态",变成了可以对标的指标。
文献来源:Goldmacher GV, et al. Contemp Clin Trials Commun. 2026;53:101682
审评会上最安静的几秒,往往出现在同一份影像被给出两个结论的时候。
研究者判 PR,中心阅片判 PD。数据管理团队把两份评估并排放进对账表,然后所有人看向项目负责人,等一个解释。而这个解释通常很难给出——在此之前,行业里没有一张公开的标尺,可以回答"这个差异到底算不算大"。
只知道差异存在,不知道差异的正常范围。这件事在肿瘤注册试验里持续了很多年。
2026年9月3日,《Contemporary Clinical Trials Communications》刊出一项研究,由默克(Merck)临床影像团队与纪念斯隆凯特琳癌症中心(MSKCC)Lawrence H. Schwartz 合作完成,第一次把研究者与独立中心评估的差异率,量化到了个例层面。
01.
差异不是"看错了"
要读懂这项研究,先得放下一个惯性假设:不一致,意味着有一方判断有误。
RECIST 1.1 的评估链条从基线开始。从全部病灶中选出最多 5 个靶病灶、每个器官不超过 2 个,用最长径之和衡量肿瘤负荷的后续变化。主观判断从"选病灶"这一步就已经进入流程,此后每一步都无法完全消除。
在实际项目中,分歧最集中的位置有三个。
1基线测量的边界认定
肿瘤边缘模糊时,长径量在哪里本身就是判断。基线偏大一点,随访中达到缩小30%的阈值就更容易;基线偏小,同样的治疗效应可能被记为 SD。中心阅片遵循统一SOP,测量尺度更刚性,但这种刚性只统一了标准,并没有消灭边界本身的模糊。
2新病灶的判定
研究者在一线面对的是具体的人,对微小的不确定结节,更倾向于留到下个周期复查确认;中心阅片在盲态下逐时间点比对,识别出新病灶即判 PD。这一步直接改写 PFS 的事件时间。
3临界病例
肿瘤缩小比例落在阈值附近时,测量值与判定结果之间的距离被压缩到最小,任何一点测量波动都可能改变结论。
关于第一点,文献里已有系统性证据。Dello Russo等人2021年发表于《Journal of Clinical Pharmacology》的汇总分析显示,在 II 期肿瘤试验中,研究者对 ORR 的评估显著高于盲态独立中心评估;2022年发表于《Frontiers in Pharmacology》的综述进一步指出,在非对照试验中这种高估具有一致的方向性。Beaumont 等人2018年在《Cancer Imaging》发表的研究,则把差异与影像质量变异、病灶选择联系起来,说明分歧的来源并不全在阅片环节。
结论很明确:差异是这套测量方式的固有属性,它的存在不需要用"有人失误"来解释。
02.
基准数字
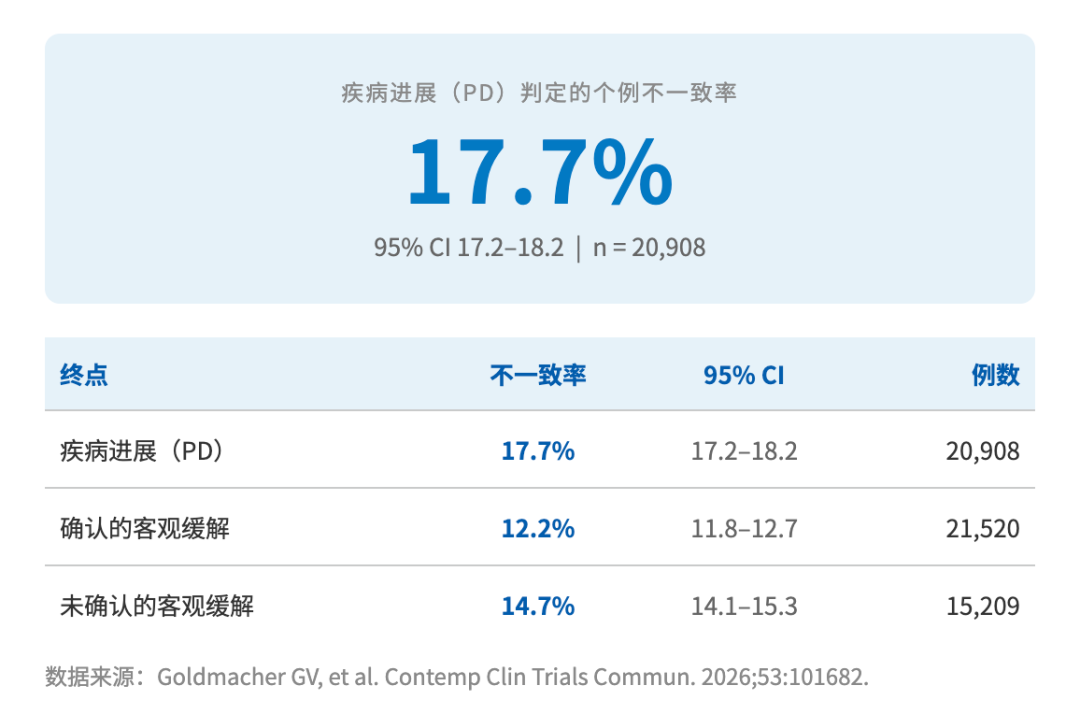
研究的做法是"回头看"。作者汇总了 39 项 II 期与 III 期实体瘤试验,全部采用以 pembrolizumab 为基础的方案,影像同时经过研究者与 BICR 评估,统一按 RECIST 1.1 判读。用 2×2 表逐例计算两套评估的不一致,得到三组基准数字。
按这个数字,大约每 6 例受试者中,就有 1 例的进展判定,在研究者和中心阅片之间出现了分歧。
作者给这项工作的定位是"经验基准",用途写得很克制:帮助研究团队判断观察到的差异率属于预期波动,还是数据质量信号。这句话的分量,在于这项研究之前,这个判断没有公共依据。
按这个数字,大约每 6 例受试者中,就有 1 例的进展判定,在研究者和中心阅片之间出现了分歧。作者给这项工作的定位是"经验基准",用途写得很克制:帮助研究团队判断观察到的差异率属于预期波动,还是数据质量信号。这句话的分量,在于这项研究之前,这个判断没有公共依据。
03.
癌种之间的距离,
比想象中大
基准数字之外,更值得注意的是癌种之间的差距。
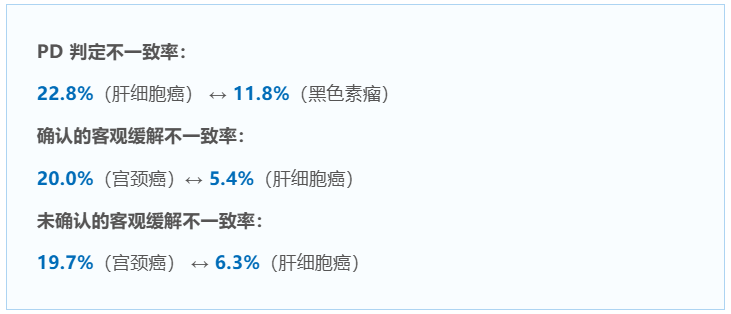
肝细胞癌在两个方向上给出了相反的极端值:进展判定最难达成一致,缓解判定却最容易。这个现象提示一件事——不同瘤种之间的差异,不是"整体一致性好不好"的差别,而是"哪一类判定容易分歧"的差别。
需要说明,论文只报告了数字,没有对癌种间差异做因果解释。从影像学角度看,这种分布有其合理性:肝细胞癌的进展判定长期受困于肝硬化背景、治疗后坏死、以及强化方式改变带来的判读困难;妇科肿瘤的缓解判定则受盆腔解剖与放疗后改变的影响。这部分属于解释性推断,不能当作论文结论引用。
对项目的实际含义很直接:用基准对照时,必须按癌种匹配。拿一个跨瘤种的总平均值去评价一个肝细胞癌项目的差异率,会得出错误结论。
04.
两个与直觉相反的发现
其一:实时进展核验,
与更低的差异率相关
设置了进展实时核验(real-time verification of progression)的试验,PD 判定不一致率为 17.3%(95% CI 16.7–17.8);未设置的试验为 20.2%(95% CI 18.8–21.7)。相差接近 3 个百分点。
这是整篇研究中少数几个指向"可干预"的结果:差异率不是固定的,流程设计能对它产生影响。但作者没有做因果论证,这是观察性比较——设置实时核验的试验,可能在其他流程标准上同样更严格,两者在这批数据里无法拆开。把它读成"加了核验就能降低差异",超出了数据能支持的范围。
其二:是否设盲,
与 PD 判定的差异率关系不大
行业里常说开放标签试验的评估偏倚风险更高,因此在开放标签设计中更依赖 BICR。但在这批数据里,PD 判定的不一致率在双盲与开放标签试验中几乎相同——17.6%(16.9–18.3)对 17.8%(17.0–18.6)。
反倒是确认的客观缓解,在双盲试验中的不一致更高:13.3%(12.7–13.9)对 10.9%(10.3–11.6)。作者未对此给出明确解释。
这组结果的实际意义在于:在设计讨论中,"我们这个试验是开放标签,所以差异大"不能作为解释差异率的依据。差异的来源更可能落在测量与判读的细节上,而不是是否设盲这个单一变量。
05.
监管对"差异"的要求,
正在变细
差异必须被呈现,在注册层面不是选项。ICH E3(临床研究报告的结构与内容)要求,当关键疗效指标由两个独立方分别评估时,报告需完整呈现两套评估结果,并逐一识别结论不一致的个体病例,且在后续分析中始终保持"哪一套结果被用于主要分析"是透明的。
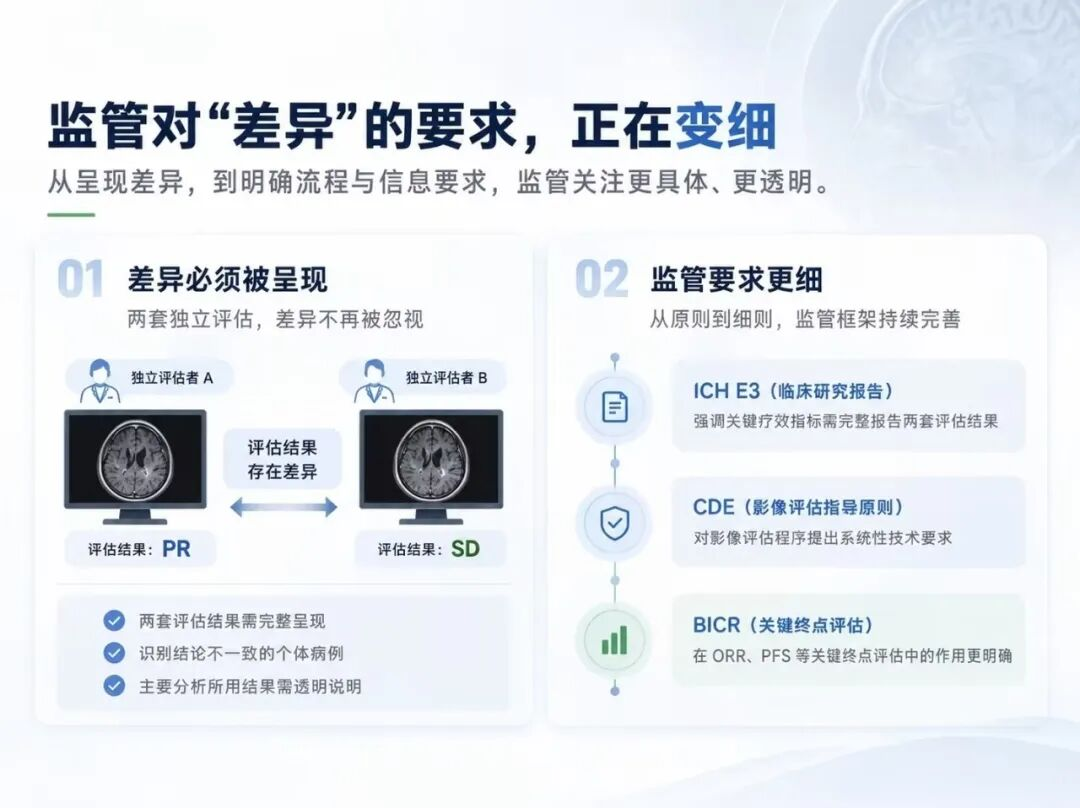
中国监管框架的演进同样清晰。2021 年,CDE 发布《抗肿瘤药临床试验影像评估程序标准技术指导原则》,第一次为国内影像评估程序确立了系统性技术要求,把独立评估委员会的设立列为重要设计考量,并明确单臂试验中须采用盲态独立中心审查。
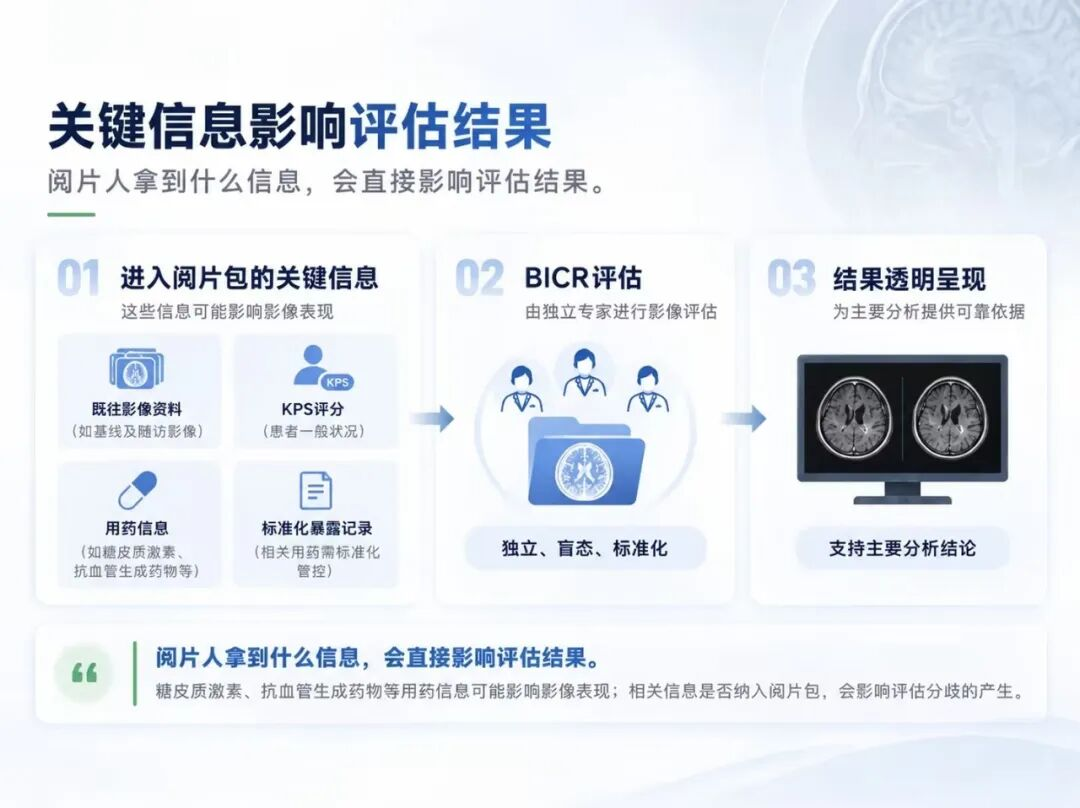
今年 7 月 31 日,CDE 就《脑胶质瘤治疗药物研发临床试验设计技术指导原则(征求意见稿)》公开征求意见。这份文件在影像评估上给出了更细的要求:基于肿瘤测量评估的主要研究终点(如 ORR、PFS)通常应由 BICR 评估;并特别提出,BICR 应能获取患者既往影像资料、KPS 评分、以及糖皮质激素和抗血管生成药物的使用信息,以降低评估偏倚;试验过程中还需对这两类药物的使用进行标准化管控,并将暴露量纳入统计分析。
最后这一条值得多看一眼。它在监管文本层面确认了一个判断:阅片人拿到什么信息,会直接影响评估结果。糖皮质激素和抗血管生成药物会改变影像表现,如果这些信息不进阅片包,分歧的产生就带有流程性原因。
06.
拿到基准之后,
项目上可以做的三件事
1把不一致率当作过程指标而不是事后争辩的材料
基准给了对照系。在试验进行中按访视或按阶段计算 PD、OR 的不一致率,与癌种匹配的基准对照。落在预期区间内的差异,不需要额外解释;明显偏离的,去查原因——影像质量、病灶选择的一致性、章程执行的偏差,都是可查的方向。差异从会议室里的紧张时刻变成一条可以看的曲线,这是基准最大的价值。
2把投入前置到影像采集端
差异的上游在影像本身。设备技术认证、扫描参数统一(层厚、造影剂方案、时相)、基线病灶选取的校准,这些工作在试验启动阶段完成,成本最低。等到阅片环节出现分歧再去追因,可调整的空间已经很小。
3在章程和统计分析计划里
预先写好差异的处理规则
什么情形触发复核、复核过程如何留痕、两套评估结果在 CSR 中如何并列呈现而非合并——这些应当在试验开始前确定。审评时被追问的往往不是差异的存在,而是差异的处理是否预先定义、是否可追溯。
最后一句提醒。这项研究的边界是清楚的:数据全部来自以 pembrolizumab 为基础方案的试验,作者本人也提示,非免疫治疗药物套用这组数字时需要谨慎。基准的用途是帮助判断,不是为异常提供解释。
结语
肿瘤影像评估至今仍是一项带有判断成分的测量工作。承认这一点,比反复强调"标准化"更接近实际。17.7% 这个数字,不会让任何项目的问题自动消失。它的意义在于,当两套评估再次对不上时,团队可以先把数字放到标尺上量一量,再决定要不要紧张。
真正需要担心的
不是差异本身
而是差异来路不明
参考来源
1. Goldmacher GV, Goldberg CM, Boyle L, Jia L, Gause CK, Green MC, Schwartz LH. Setting the standard: empirical benchmarks for case-level site-central discordance in radiographic endpoints in oncology clinical trials. Contemp Clin Trials Commun. 2026;53:10168
2. doi:10.1016/j.conctc.2026.1016822. Dello Russo C, Cappoli N, Pilunni D, Navarra P. Local investigators significantly overestimate overall response rates compared to blinded independent central reviews in phase 2 oncology trials. J Clin Pharmacol. 2021;61:810-819.
3. Dello Russo C, Navarra P. Local investigators significantly overestimate overall response rates compared to blinded independent central reviews in uncontrolled oncology trials: a comprehensive review of the literature. Front Pharmacol. 2022;13:858354.
4. Beaumont H, Evans TL, Klifa C, Guermazi A, et al. Discrepancies of assessments in a RECIST 1.1 phase II clinical trial — association between adjudication rate and variability in images and tumors selection. Cancer Imaging. 2018;18:50.
5. Siegel MJ, Ippolito JE, Wahl RL, Siegel BA. Discrepant assessments of progressive disease in clinical trials between routine clinical reads and formal RECIST 1.1 interpretations. Radiol Imaging Cancer. 2023;5:e230001.
6. 国家药品监督管理局药品审评中心.《抗肿瘤药临床试验影像评估程序标准技术指导原则》. 2021 年第 1 号.7. 国家药品监督管理局药品审评中心.《脑胶质瘤治疗药物研发临床试验设计技术指导原则(征求意见稿)》. 2026 年 7 月 31 日.
临影医药
临影医药(有临医药全资子公司)成立于2017年,总部位于上海,是第三方独立医学影像CRO (Independent Review Committee, IRC),为创新药物临床研究提供第三方独立影像评估服务,确保试验结果的客观性和科学性,加速临床试验、注册审批的进程,助力新药上市。